

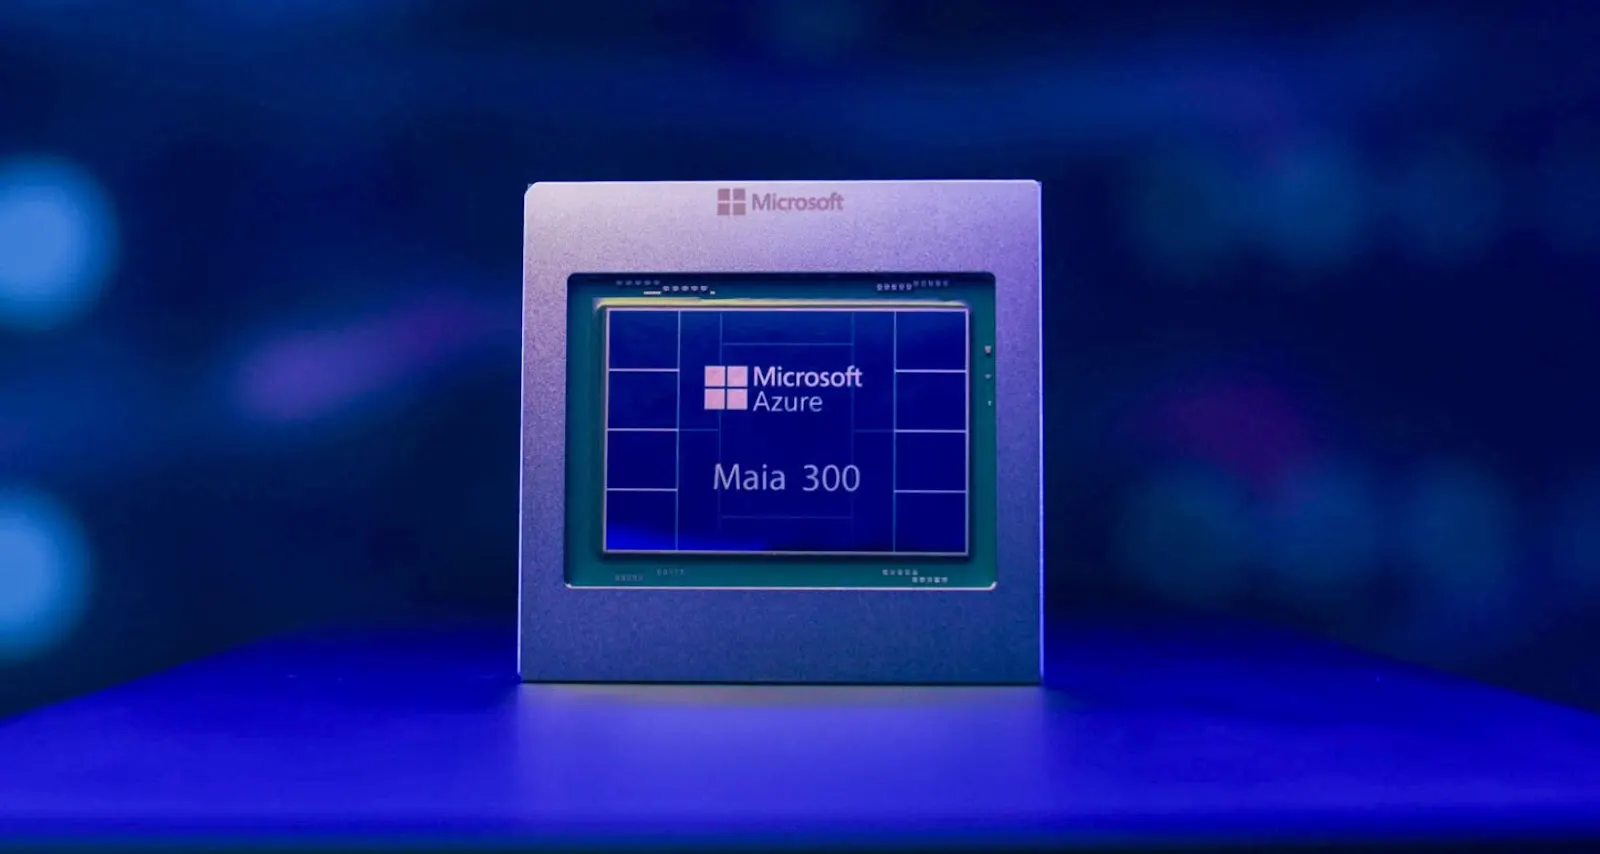
Microsoft ha presentato Maia 300, la nuova generazione del proprio acceleratore progettato specificamente per l’inferenza AI. Il chip sarà alla base di una forte espansione dell’infrastruttura Azure, con implementazioni su scala multi-gigawatt previste dal 2027, e secondo i piani dell’azienda diventerà progressivamente il principale sistema di inferenza utilizzato dai prodotti e servizi Microsoft.
Maia 300 arriva meno di un anno dopo Maia 200
La nuova generazione viene annunciata a meno di un anno dalla presentazione di Maia 200 e rappresenta un ulteriore passo nella strategia di Microsoft di progettare insieme hardware, infrastruttura cloud e software AI. L’obiettivo non è semplicemente aumentare la potenza disponibile, ma costruire sistemi ottimizzati per i carichi di lavoro che Azure deve già gestire su scala globale e per quelli che stanno emergendo con la diffusione degli agenti AI.
Progettato per ragionamento, conversazioni e agenti AI
Microsoft indica tra i carichi di lavoro principali il ragionamento su contesti molto estesi, le esperienze conversazionali sensibili alla latenza e le attività agentiche prolungate composte da numerosi passaggi. Si tratta di scenari nei quali non conta soltanto la capacità di eseguire il modello, ma anche mantenere tempi di risposta ridotti e un’elevata efficienza quando milioni di utenti utilizzano contemporaneamente servizi basati sull’intelligenza artificiale.
Fino al 40% di token in più per megawatt
Uno dei dati più rilevanti riguarda l’efficienza energetica dell’intero sistema. Microsoft prevede che Maia 300 possa generare fino al 40% di token in più per megawatt rispetto ai principali sistemi basati su GPU, un parametro particolarmente importante nei data center AI dove disponibilità energetica, raffreddamento e densità di calcolo stanno diventando fattori sempre più critici.
Un rack con 96 acceleratori punta a moltiplicare le prestazioni
In una configurazione completa composta da 96 acceleratori Maia 300, Microsoft dichiara una capacità di elaborazione a livello di rack fino a sette volte superiore in termini di token rispetto a Maia 200. Il confronto mostra quanto rapidamente stia evolvendo la piattaforma proprietaria e quanto Microsoft punti a ridurre il costo infrastrutturale necessario per eseguire servizi AI su grandissima scala.
Maia 200 è già in distribuzione in più continenti
La generazione precedente, Maia 200, è attualmente in fase di implementazione negli Stati Uniti, in Europa e in Australia. Microsoft afferma che il sistema può offrire fino a 1,7 volte più token per watt per alcune funzionalità AI integrate in Microsoft Teams, Copilot e nelle esperienze Cowork utilizzate quotidianamente da centinaia di milioni di persone.
Hardware e software progettati insieme
Uno dei vantaggi strategici di Maia è la possibilità per Microsoft di sviluppare l’hardware partendo direttamente dai carichi di lavoro dei propri servizi. L’azienda può quindi intervenire contemporaneamente su acceleratori, rack, software e modelli, cercando di ottimizzare l’intera catena anziché adattare applicazioni già esistenti a un’infrastruttura progettata da terzi.
GitHub potrà sfruttare Maia per gli agenti di coding
Maia 200 e Maia 300 sono progettati per supportare anche attività agentiche multi-step. Microsoft cita in particolare GitHub, dove l’infrastruttura potrà contribuire a eseguire in modo più efficiente esperienze di coding basate su agenti capaci di affrontare attività articolate in più passaggi.
Microsoft Foundry e i modelli su scala cloud
Un altro ambito riguarda Microsoft Foundry, che dovrà supportare differenti architetture AI e più ambienti di deployment. Maia è pensato per contribuire all’erogazione dei modelli su scala cloud, consentendo a Microsoft di gestire una gamma sempre più ampia di servizi senza dipendere esclusivamente dagli acceleratori GPU tradizionali.
Maia servirà anche ai team AI interni di Microsoft
La piattaforma verrà utilizzata anche per attività di inferenza e generazione di dati a supporto dei team AI Microsoft. Questo significa che Maia non sarà limitato ai prodotti destinati direttamente agli utenti, ma potrà diventare parte dell’infrastruttura impiegata per sviluppare, testare e migliorare nuovi modelli e servizi.
Dragon Copilot punta sulla bassa latenza
Microsoft cita anche Dragon Copilot, dove tempi di risposta molto ridotti sono essenziali per rendere più fluidi i workflow destinati ai professionisti sanitari. L’obiettivo è ampliare le attività che il sistema può gestire e ridurre il carico amministrativo, facendo affidamento su un’infrastruttura capace di rispondere rapidamente anche in scenari complessi.
Dal 2027 un’espansione su scala multi-gigawatt
La parte più ambiziosa del progetto riguarda l’espansione dell’infrastruttura Azure basata su Maia. Microsoft prevede implementazioni multi-gigawatt a partire dal 2027, una scala che mostra come l’azienda consideri Maia non un semplice esperimento interno, ma una componente strategica della propria infrastruttura AI futura.
Microsoft vuole ridurre la dipendenza dai sistemi GPU tradizionali
Maia 300 rappresenta anche un passaggio importante nella corsa dei grandi operatori cloud verso acceleratori proprietari. Progettando direttamente i chip utilizzati per eseguire Copilot, Teams, GitHub e altri servizi, Microsoft può cercare maggiore controllo su prestazioni, consumi e costi, ottimizzando l’hardware in funzione dei propri carichi di lavoro reali.
Se Maia 300 manterrà i livelli di efficienza dichiarati, pensate che i chip proprietari dei grandi provider cloud possano diventare una vera alternativa alle GPU tradizionali per l’inferenza AI?
zazoomtek